Saturation 함수를 이용해 매치점수와 인기도 기반 검색 경험 개선하기
# 서론
최근 모의주식 투자 웹 서비스 ‘무주시’를 리팩토링하며 MongoDB 내 데이터를 제거하고, MySQL로 이관하기로 결정하였다. 이에 따라 주식 종목별 검색 통계를 저장하던 MongoDB 도큐먼트 StockItem도 MySQL로 이관할 대상에 포함되었다.
또한, 기존 검색 기능은 MognoDB의 정규식 패턴 매칭으로 종목명을 조회한 뒤, 검색 빈도를 기준으로 결과를 정렬하는 구조였다. 하지만, 단순히 문자열 매칭과 검색 빈도만으로 결과의 우선 순위를 결정하는 방식에는 한계가 있다고 판단하였고, 이에 데이터 이관을 계기로 검색 로직도 함께 개선하기로 결정하였다.
처음에는 Elasticsearch를 도입을 고려했다. 하지만 서비스를 Azure 프리티어 VM에서 운영하고 있어 제한된 서버 자원으로 Elasticsearch를 운용하기에는 부담이 있었다. 따라서, 별도의 검색 서버를 두는 대신, 애플리케이션 내부에서 직접 인덱스를 구축하기로 결정하였다.
이전에 별도의 토이 프로젝트를 진행하며 Elasticsearch를 학습한 경험이 있다. 당시 Elasticsearch가 내부적으로 Lucene을 사용해 인덱스를 생성하고 검색을 수행한다는 점을 알게 되었다. Lucene은 Elasitcsearch의 핵심 검색 라이브러리이므로, 별도의 검색 서버를 운영하지 않고도 애플리케이션에서 직접 검색 인덱스를 구축할 수 있다고 판단하였다.
eleastic/elasticsearch - [DOCS] Fix outdated default stoptags example (E, J) in nori_part_of_speech docs 이슈를 작성하고 해결하며 Lucene 라이브러리의 존재를 알게되었다.
이번 글에서는 검색에어와 종목명의 일치도를 나타내는 ‘매치 점수’와 종목의 ‘인기도’를 함께 반영하되, 인기도가 검색 관련성(매치 점수)보다 큰 영향을 미치지 않도록 최종 점수를 설계한 과정을 정리하고자 한다.
# 본론
검색 흐름(Search Flow)
전체 검색 흐름은 다음과 같다.
1. 검색어(keyword)를 통해 인덱스 검색
2. 검색 결과 Document를 DTO로 변환하면 매치 점수 계산
3. 검색 결과에 포함된 주식 종목의 인기도(검색 빈도)를 조회
4. 매치 점수와 인기도를 조합하여 최종 점수를 계산
5. 최종 점수를 기준으로 검색 결과를 정렬하여 반환
이 과정에서 핵심은 매치 점수와 인기도(검색 빈도)를 조합하여 최종 점수를 계산하는 것이다.
매치 점수와 인기도를 활용한 검색
주식 종목 검색 기능의 서비스 상단의 검색창을 통해 제공된다.
검색 결과에는 검색어와의 일치도뿐만 아니라, 종목의 인기도도 반영하여 사용자들이 많이 조회된 종목이 상위에 노출되도록 하고자 하였다.
인기도는 해당 종목의 상세 페이지가 조회된 횟수를 의미하며, 사용자가 상세 페이지를 접근할 때마다 증가한다.
매치 점수
매치 점수는 사용자가 입력한 검색이(keyword)와 검색 결과의 종목명이 일치하는 정도를 나타내는 지표이다. 일치 유형에 따라 다음과 같이 점수를 부여하였다.
- 검색어와 종목명이 완전히 일치하는 경우:
100 - 검색어가 종목명의 접두어와 일치하는 경우:
50 - 그 외의 경우:
30
현재 검색에서는 PrefixQuery를 사용하므로, 반환되는 모든 결과는 종목명이 검색어로 시작한다. 따라서, 현재 구조에서는 완전 일치 또는 접두어 일치에 해당하지만, 향후 오타 검색 등 다른 검색 방식을 추가할 가능성을 고려하여 기본 점수도 함께 정의하였다.
@Getter
@RequiredArgsConstructor
public enum StockSearchMatchType {
    EXACT(100),
    PREFIX(50),
    DEFAULT(30),
    ;

    private final int score;

    /**
     * 모든 매치 타입의 점수 중 인접한 두 점수 간 최소 차이를 반환하는 메서드
     *
     * <p> 주식 검색 결과의 매치 점수와 검색 빈도를 통한 최종 점수 계산 시 검색 빈도의 상한선에 사용한다.
     *
     * @return 인접한 점수 간 최소 차이
     */
    public static int minScoreGap() {
        int[] sortedScores = Arrays.stream(values())
                .mapToInt(StockSearchMatchType::getScore)
                .sorted()
                .toArray();

        int minGap = Integer.MAX_VALUE;
        for (int i = 1; i < sortedScores.length; i++) {
            minGap = Math.min(minGap, sortedScores[i] - sortedScores[i - 1]);
        }
        return minGap;
    }
}
매치 유형과 점수는 enum으로 관리한다. minScoreGap은 인접한 매치 점수 사이의 최소 간격을 계산하며, 반환된 값은 이후 최종 점수를 계산할 때 인기도가 미칠 수 있는 영향의 상한선으로 사용된다. 자세한 내용은 최종 점수 계산에서 추가적으로 설명할 예정이다.
public class StockSearchNameMatchScorer {
    /**
     * 검색 결과 주식 이름({@code stockName})과 검색 키워드({@code keyword}) 간 유사도 점수를 반환하는 메서드
     *
     * <ul>
     *     <li>완전히 동일한 경우, {@link StockSearchMatchType#EXACT}를 반환</li>
     *     <li>키워드가 결과의 접두어인 경우, {@link StockSearchMatchType#PREFIX}를 반환</li>
     *     <li>그 외의 경우, {@link StockSearchMatchType#DEFAULT}를 반환</li>
     * </ul>
     *
     * @param stockName 검색 결과 주식 이름
     * @param keyword   검색 키워드
     * @return          유사도 점수
     */
    public static double matchScore(String stockName, String keyword) {
        if (stockName.equals(keyword)) {
            return StockSearchMatchType.EXACT.getScore();
        }

        if (stockName.startsWith(keyword)) {
            return StockSearchMatchType.PREFIX.getScore();
        }

        return StockSearchMatchType.DEFAULT.getScore();
    }
}
매치 점수는 사용자가 입력한 검색어 keyword와 검색 결과 도큐먼트의 종목명 필드인 stockName을 비교하여 계산한다.
인기도
인기도는 해당 주식 종목이 사용자들에게 얼마나 많이 조회되었는지를 나타내는 지표이다.
검색어와 일치도(매치 점수)가 같은 결과 중 사용자가 많이 조회한 종목을 우선 노출하기 위해 인기도를 최종 점수에 반영한다.
@Getter
@NoArgsConstructor(access = AccessLevel.PROTECTED)
@Entity
@Table(name = "stock_search_stat")
public class StockSearchStat {
    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(name = "stock_code", unique = true, nullable = false)
    private String stockCode;

    @Column(name = "search_count", nullable = false)
    private int searchCount;

    @Builder
    public StockSearchStat(String stockCode) {
        this.stockCode = stockCode;
    }
}
각 주식 종목의 조회 횟수 searchCount는 종목 코드 stockCode와 함께 저장한다. 검색 결과에 포함된 종목 코드를 기준으로 해당 종목의 조회 횟수를 조회하기 위함이다.
최종 점수 계산
검색 결과를 정렬하려면 매치 점수와 인기도를 조합해 최종 점수를 산출해야한다. 그렇다면 두 값은 어떤 방식으로 반영해야 적절한 검색 순위를 만들 수 있을까?
매치 점수와 인기도를 단순히 더한다면?
두 값을 조합하는 가장 간단한 방법은 매치 점수와 인기도를 그대로 더하는 것이다.
최종 점수 = 매치 점수 + 인기도
이 방식은 계산이 단순하며 매치 점수와 인기도를 모두 반영할 수 있으므로, 겉보기에는 요구 사항을 만족하는 것처럼 보인다.
그러나 매치 점수는 정해진 범위 안에서 부여되는 반면, 인기도(조회 횟수)는 시간이 지날수록 계속 증가한다. 따라서, 단순 합산 방식에서는 인기도가 최종 점수에 미치는 영향도 제한이 없이 커진다.
# 검색어 (키워드)
삼성전자

# 검색 결과와 매치 점수
삼성전자 (100점)
삼성전자일까요 (50점)

# 인기도
삼성전자 (30회)
삼성전자일까요 (200회)

# 최종 점수
삼성전자 = 100 + 30 = 130 (점)
삼성전자일까요 = 50 + 200 = 250 (점)
위 예시에서는 검색어와 완전히 일치하는 삼성전자보다 접두어만 일치하는 삼성전자우의 최종 점수가 더 높다. 검색어와의 일치도보다 인기도가 검색 순위를 좌우하면서 검색 결과의 우선 순위가 의도와 다르게 뒤바뀌는 현상이 발생한 것이다.
인기도가 일정 수준에 도달할 때마다 조회 횟수를 초기화하는 방법도 고려할 수 있다. 그러나 조회 횟수는 서비스 이용에 따라 계속 누적되는 값이므로, 초기화 시점을 지속해서 관리해야 할뿐만 아니라 기존 인기도 정보도 잃게 된다. 또한, 합산 결과가 오버플로우가 될 위험성 등도 존재한다. 따라서, 합산 구조는 근본적인 문제를 해결하기는 어렵다.
따라서, 기존 요구사항에 다음 조건을 추가하였다.
인기도는 검색 순위에 반영하되, 그 영향으로 매치 점수에 따른 우선 순위가 뒤바뀌어서는 안된다.
해결 방안
단순 합산 방식의 문제는 인기도가 계속 증가하면서 검색어와의 일치도보다 최종 순위에 더 큰 영향을 미친다는 점이다. 그 결과, 검색어와 완전히 일치하는 종목이 부분적으로 일치하는 종목보다 낮은 순위로 노출될 수 있는 문제점을 인식하였다.
이를 방지하기 위해 인기도가 최종 점수에 기여할 수 있는 범위에 상한선을 두기로 결정하였다. 이는 인기도 자체를 제한하는 것이 아니라, 인기도가 매치 점수 이상의 영향을 미치지 않도록 값을 조정한 뒤 최종 점수에 반영하는 것이다.
인기도 보정값을 매치 점수 사이의 최소 간격보다 작게 제한하면, 인기도가 아무리 높아져도 매치 유형에 따른 우선 순위는 뒤바뀌지 않는다. 동시에 매치 점수가 같은 결과끼리는 인기도에 따라 순서를 정할 수 있으므로 두 요구사항을 모두 만족할 수 있다.
Saturation 함수
인기도가 최종 점수에 미치는 영향을 일정 범위로 제한하기 위해 가장 먼저 떠올린 보정 방법은 시그모이드(Sigmoid) 함수였다.
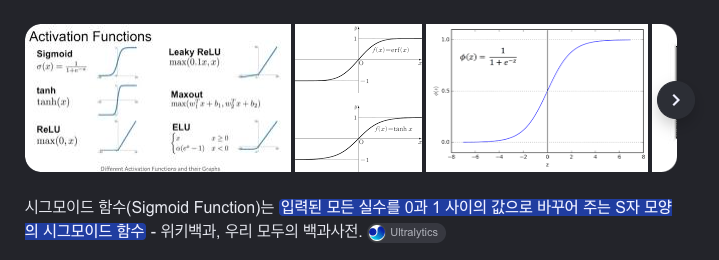
시그모이드 함수는 인공지능 전공 수업에서 활성화 함수로 접한 적이 있었다. 또한 Elasticsearch를 학습하면서 검색 점수를 조정하는 방법으로 시그모이드 함수를 사용할 수 있다는 문서를 읽은 경험도 있었다.
시그모이드 함수의 출력값이 (0, 1) 범위로 제한된다는 특성을 활용하면 인기도의 영향도 제한할 수 있을 것이라 생각하였다.
이에 Elasticsearch에서 시그모이드 함수가 어떻게 활용되는지 찾아보았고, Specialized Query - Rank Feature Query 문서에서 관련 내용을 확인했다. 이 문서를 살펴보는 과정에서 Saturation 함수(포화 함수)도 함께 알게 되었다.
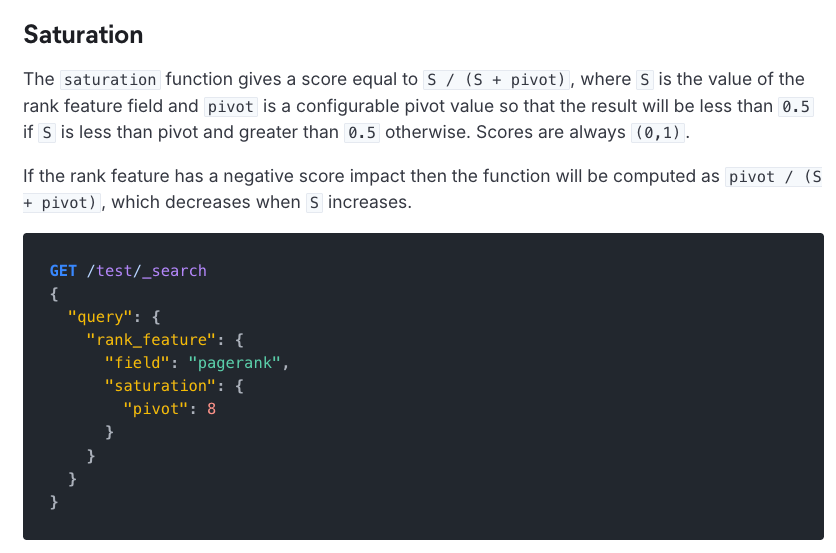
Saturation 함수 역시 입력값을 제한된 범위로 변환한다. 점수 Score와 PIVOT이 0 이상일 때 사용하는 공식은 다음과 같다.
Score / (Score + PIVOT)
Score가 0이면 결과도 0이며, Score와 Pivot이 같으면 0.5가 된다. 이후 Score가 계속 증가하더라도 결과는 1에 가까워질 뿐 1 이상을 커지지 않는다. 따라서, 출력값의 범위는 [0, 1)로 제한된다.
이러한 특성을 이용하면 계속해서 누적되는 인기도(조회 횟수)를 제한된 범위의 보정값으로 변환하여 최종 점수에 반영할 수 있다고 생각하였다.
Sigmoid가 아닌 Saturation을 선택한 이유
Sigmoid와 Saturation은 모두 출력값을 제한된 범위로 변환할 수 있다. 그러나, 이번 요구사항에서는 Saturation 함수가 더 적합하다고 판단하였다.
Sigmoid 함수는 완만하게 증가하다가 특정 구간에서 가파르게 증가한 후 다시 완만해지는 형태라면, Saturation 함수는 입력값이 증가할수록 출력값도 증가하지만, 그 증가폭은 점차 감소한다. 따라서, 계속 누적되는 인기도도의 특성 상 Saturation 함수가 더 적합하다고 판단하였다.
또한 Saturation 함수는 인기도가 0이면 결과도 0이므로, 조회되지 않은 종목에 별도의 보정값을 부여하지 않을 수도 있다. 필요한 매개변수도 PIVOT 하나뿐이어서 인기도가 어느 시점부터 완만하게 반영될지를 비교적 직관적으로 조정할 수 있다.
PIVOT이 0보다 클 경우 Staturation 함수의 결과는 항상 [0, 1) 범위에 속한다. 따라서 결과에 가중치 W를 곱하면 인기도 보정값을 [0, W) 범위로 제한할 수 있다.
0 <= W × Saturation(S) < W
이를 통해 인기도가 아무리 증가하더라도 최종 점수에 미치는 영향은 W 미만으로 유지할 수 있다.
또한, Saturatioin 함수는 나눗셈과 덧셈같은 간단한 연산만으로 계산할 수 있지만, Sigmoid 함수는 Math.exp()를 사용한다. 필자는 두 함수의 성능에서도 차이가 난다고 생각하여 이를 확인하고조 간단하게 테스트를 진행하였다.
class SaturationVsSigmoidFunctionBenchmarkTest {
    private static final int PIVOT = 100;
    private static final double SIGMOID_K = 0.03;
    private static final int WARM_UP_ROUNDS = 3;
    private static final int MEASURE_ROUNDS = 5;
    private static final int ITERATIONS = 30_000_000;
    private static final int COUNTS_SIZE = 1024; // 2의 거듭제곱 (인덱스 마스킹용)

    // JIT의 dead code elimination 방지용
    private static volatile double sink;

    private static double saturation(int score) {
        return (double) score / ((double) score + PIVOT);
    }

    private static double sigmoid(int score) {
        return 1.0 / (1.0 + Math.exp(-SIGMOID_K * (score - PIVOT)));
    }

    @Test
    @DisplayName("함수 단독 호출 비용을 비교한다")
    void benchmarkFunctionOnly() {
        int[] scores = randomScore();

        for (int i = 0; i < WARM_UP_ROUNDS; i++) {
            run(SaturationVsSigmoidFunctionBenchmarkTest::saturation, scores);
            run(SaturationVsSigmoidFunctionBenchmarkTest::sigmoid, scores);
        }

        double saturationTotal = 0;
        double sigmoidTotal = 0;
        System.out.printf("%-8s %-18s %-18s%n", "round", "saturation(ns)", "sigmoid(ns)");
        for (int round = 1; round <= MEASURE_ROUNDS; round++) {
            double saturationNs = run(SaturationVsSigmoidFunctionBenchmarkTest::saturation, scores);
            double sigmoidNs = run(SaturationVsSigmoidFunctionBenchmarkTest::sigmoid, scores);
            saturationTotal += saturationNs;
            sigmoidTotal += sigmoidNs;
            System.out.printf("%-8d %-18.2f %-18.2f%n", round, saturationNs, sigmoidNs);
        }

        double saturationAvg = saturationTotal / MEASURE_ROUNDS;
        double sigmoidAvg = sigmoidTotal / MEASURE_ROUNDS;
        System.out.printf("[평균] saturation=%.2f ns/call, sigmoid=%.2f ns/call (sigmoid/saturation = %.1f배)%n",
                saturationAvg, sigmoidAvg, sigmoidAvg / saturationAvg);
    }

    private static double run(IntToDoubleFunction function, int[] counts) {
        double acc = 0;
        long start = System.nanoTime();
        for (int i = 0; i < ITERATIONS; i++) {
            acc += function.applyAsDouble(counts[i & (COUNTS_SIZE - 1)]);
        }
        long elapsed = System.nanoTime() - start;
        sink = acc;
        return (double) elapsed / ITERATIONS;
    }

    private static int[] randomScore() {
        Random random = new Random(1);
        int[] counts = new int[COUNTS_SIZE];
        for (int i = 0; i < COUNTS_SIZE; i++) {
            counts[i] = random.nextInt(5_000);
        }
        return counts;
    }
}
워밍업을 3회 수행한 뒤 각 함수를 3천만 번씩 호출했으며, 총 5회의 측정 결과는 다음과 같았다.
round    saturation(ns)     sigmoid(ns)
1        3.61               8.57
2        3.60               9.54
3        3.50               9.50
4        3.49               9.36
5        3.58               9.30
[평균] saturation=3.56 ns/call, sigmoid=9.26 ns/call (sigmoid/saturation = 2.6배)
해당 로컬 환경에서는 Saturation 함수가 호출 당 평균 3.56ns, Sigmoid 함수가 9.26ns로 측정되어 Sigmoid 함수의 계산 시간이 약 2.6배 길었다.
그러나, 실제 주식 검색 로직에서 ns 단위 차이가 차지하는 비중은 그리 크지 않으므로, 성능 차이만으로는 함수 선택의 명확한 이유라고 말하기는 어렵다고 생각한다.
따라서, Sigmoid 함수가 아닌 Saturation 함수를 선택한 이유는 Saturation 함수의 단순한 구조와 무한히 증가하는 인기도의 상한선을 제한하여 변환하는 특성이 이번 요구사항과 잘 부합하기 때문이다.
Saturation 함수를 적용하여 최종 점수를 계산
최종 점수는 매치 점수에 Saturation 함수를 적용한 인기도 보정값을 더하여 계산한다.
final_score = match_score + W × (search_count / (search_count + PIVOT))
match_score: 검색어와 종목명의 일치도에 따른 매치 점수search_count: 해당 종목의 조회 횟수W: 인접한 매치 점수 사이의 최소 간격PIVOT: 인기도 보정값이 최대 범위의 절반에 도달하는 기준값
현재 매치 점수는 100, 50, 30이므로 인접한 점수 사이의 최소 간격은 20이다. 따라서, W는 20을 사용한다.
W = min(100 - 50, 50 - 30)
  = min(50, 20)
  = 20
Saturation 함수의 결과는 항상 [0, 1) 범위에 있으므로, 인기도 보정값 W × (S / (S + 1))의 범위는 [0, 20)으로 제한된다.
따라서, 조회 횟수가 아무리 증가해도 인기도로 얻을 수 있는 추가 점수는 매치 점수의 최소 간격인 20을 넘지않는다. 이를 통해 일치도가 다른 결과가 인기도 때문에 결과의 순위가 뒤바뀌는 것을 방지할 수 있다.
위 설계를 실제로 적용한 결과는 아래와 같다.
PIVOT= 10,- ‘삼성전자’의 인기도(조회 횟수): 30
- ‘삼성전자우’의 인기도(조회 횟수): 200
# final_score = match_score + W × (search_count / (search_count + 1))

삼성전자
= 100 + 20 × (30 / (30 + 100))
≈ 104.62

삼성전자우
= 50 + 20 × (200 / (200 + 100))
≈ 63.33
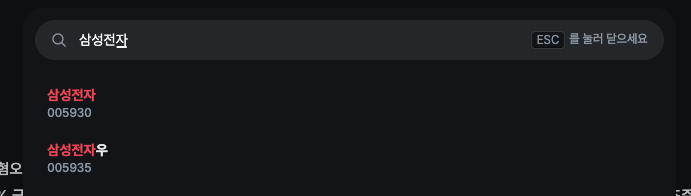
‘삼성전자우’의 조회 횟수가 더 많더라도 인기도 보정값은 W(20) 미만으로 제한된다. 따라서, 검색어에 삼성전자와 완전히 일치하는 삼성전자가 접두어만 일치하는 삼성전자우보다 먼저 노출되는 것을 확인할 수 있다.
# 결론
주식 검색 기능을 개선하며 Elasticsearch와 같은 별도의 검색 시스템을 도입하는 대신, Lucene을 이용하여 애플리케이션 내부에 검색 기능을 구현하였다. 이 과정에서 검색어와의 일치도를 나타내는 ‘매치 점수’와 종목의 ‘인기도’를 어떻게 조합해야 하는지 고민하게 되었다.
이번 문제를 해결하는 데 가장 중요했던 것은 문제를 구체적으로 정의하는 과정이었다. 처음에는 매치 점수와 인기도를 모두 최종 점수에 반영하는 것을 목표로 삼았다. 그러나, 두 값을 단순히 더하면 인기도가 검색어와의 일치도보다 더 큰 영향을 미쳐 검색 순위가 뒤바뀔 수 있다는 문제를 발견했다.
이에 요구사항을 “인기도를 반영하되 매치 유형에 따른 우선 순위는 유지해야한다” 로 구체화하였고, 인기도 보정값의 범위를 제한하는 방향으로 해결책을 찾을 수 있었다.
대학 시절 인공지능 과목에서 학습했던 시그모이드 함수의 특성이 가장 먼저 떠올랐고, 이를 출발점으로 Saturation 함수까지 살펴보게 되었다. 특정 분야에서 배운 개념을 단순히 암기하는데 그치지 않고 원리와 특성을 이해한다면, 서로 다른 분야의 문제를 해결할 떄도 활용할 수 있다는 점을 체감할 수 있었다.
남은 과제는 실제 데이터에 맞는 PIVOT 값을 결정하는 겂이다. PIVOT은 인기도 보정값이 최대 범위의 절반에 도달하는 기준값이다.
S = PIVOT인 경우

S / (S + PIVOT) = 0.5
현재는 PIVOT을 100으로 설정하였지만, 이 값이 실제 종목 별 조회 횟수의 분포를 적절하게 반영한다고 단정하기는 어렵다고 생각한다. 향후 조회 횟수의 중앙값이나 상위 사분위수(25%) 등의 통계를 분석하고, 실제 검색 결과가 의도한 순서로 노출되는지 검증하여 적절한 값을 결정할 예정이다. 조회 횟수가 계속 누적되면서 분보가 편할 수도 있다는 점을 고려하여 PIVOT을 주기적으로 조정하거나 일정 기간의 조회 데이터만 사용하는 방법을 검토할 수도 있을 것이라고 생각한다.